Docling, a biblioteca que testei e explodiu minha mente
Publicado em
Realizei uma prova de conceito com a biblioteca Docling, validando sua alta eficácia na conversão automatizada de PDFs e imagens para otimizar a criação de bases de conhecimento para IA.
Nos últimos dias, estive explorando maneiras de transformar documentos em um formato otimizado para indexação e pesquisa. Foi aí que me deparei com a biblioteca Docling, e preciso dizer: fiquei impressionado com a facilidade e precisão dela na conversão de arquivos.
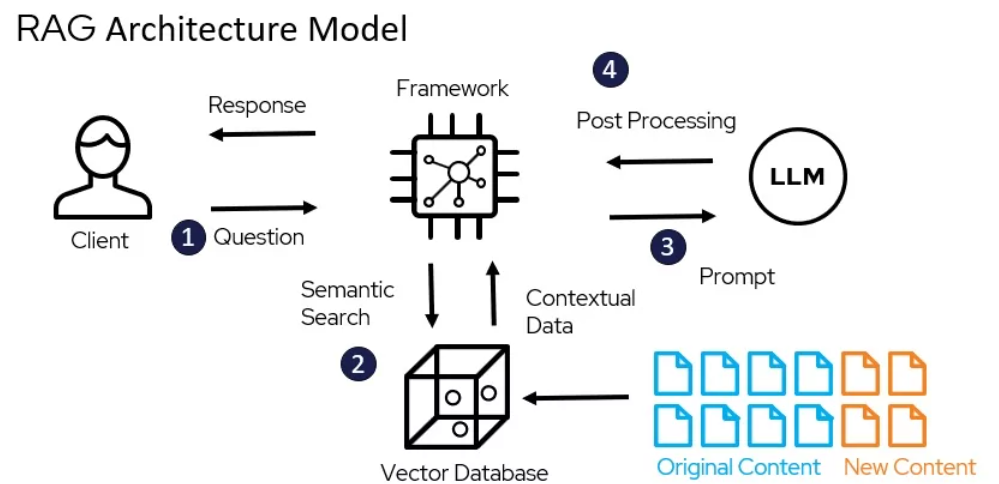
Antes de falar sobre os testes, vale contextualizar um pouco sobre a Geração Aumentada por Recuperação (RAG). RAG é uma abordagem que combina modelos de linguagem (LLM) com sistemas de recuperação de informações. Basicamente, em vez de confiar apenas nos dados que o modelo já conhece, ele busca informações em fontes externas, como documentos indexados, para fornecer respostas mais precisas e atualizadas. Para que isso funcione bem, é fundamental ter um banco de dados bem estruturado e otimizado para recuperação rápida de informações – e é aí que entra a importância da conversão eficiente de documentos.
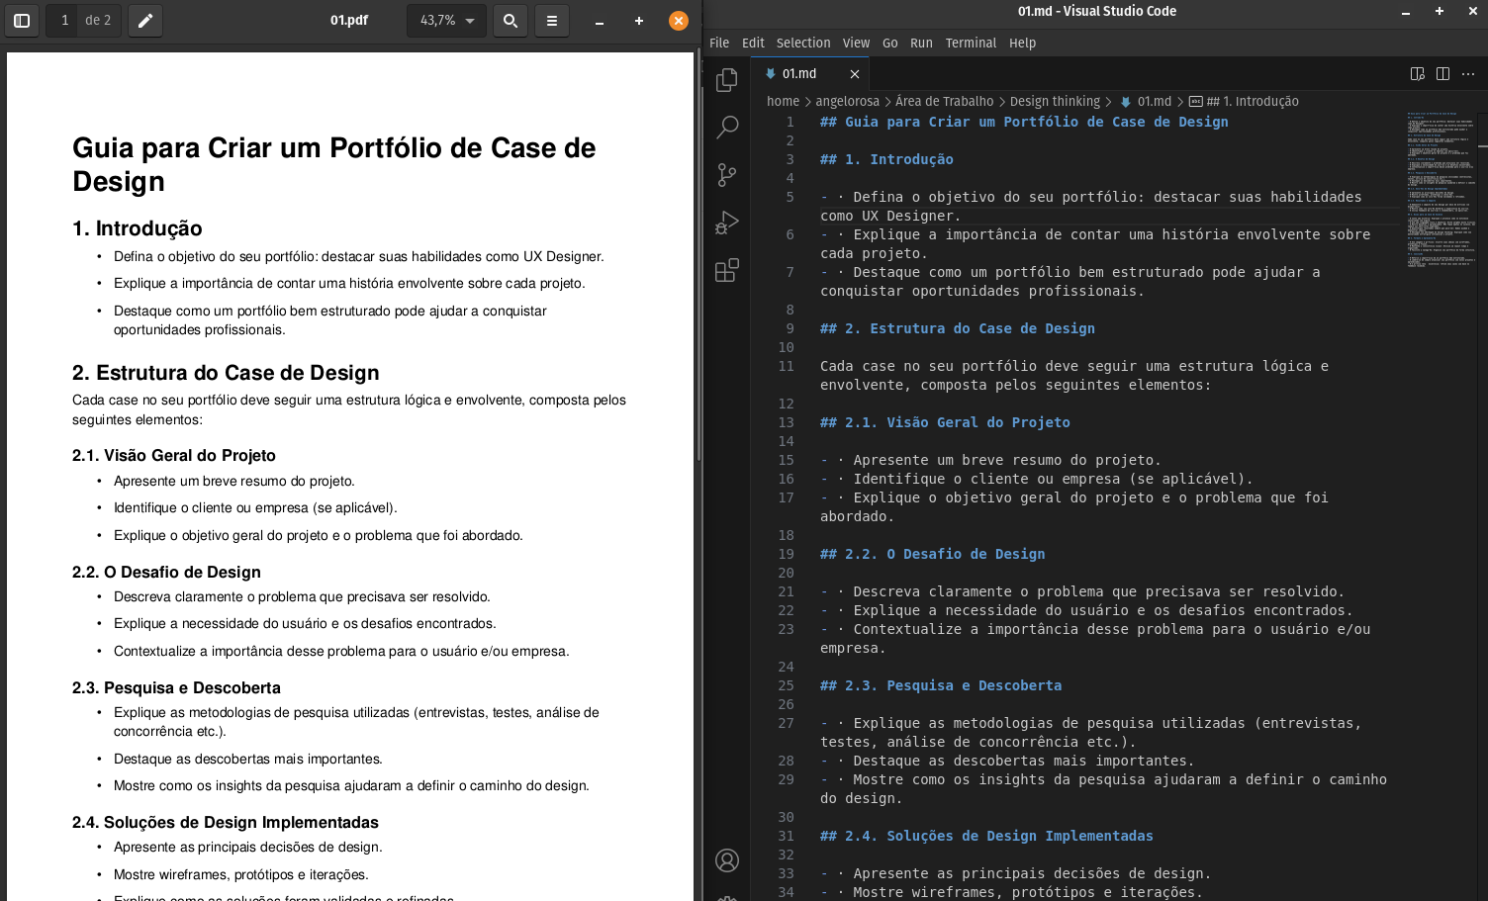
Meu primeiro teste foi com um PDF contendo apenas texto. O resultado? Perfeito. A biblioteca leu todas as informações corretamente e transformou o conteúdo em um arquivo Markdown (.md) estruturado e fiel ao original. O nível de exatidão me surpreendeu, principalmente porque muitas soluções de conversão acabam perdendo formatação ou inserindo erros no processo.
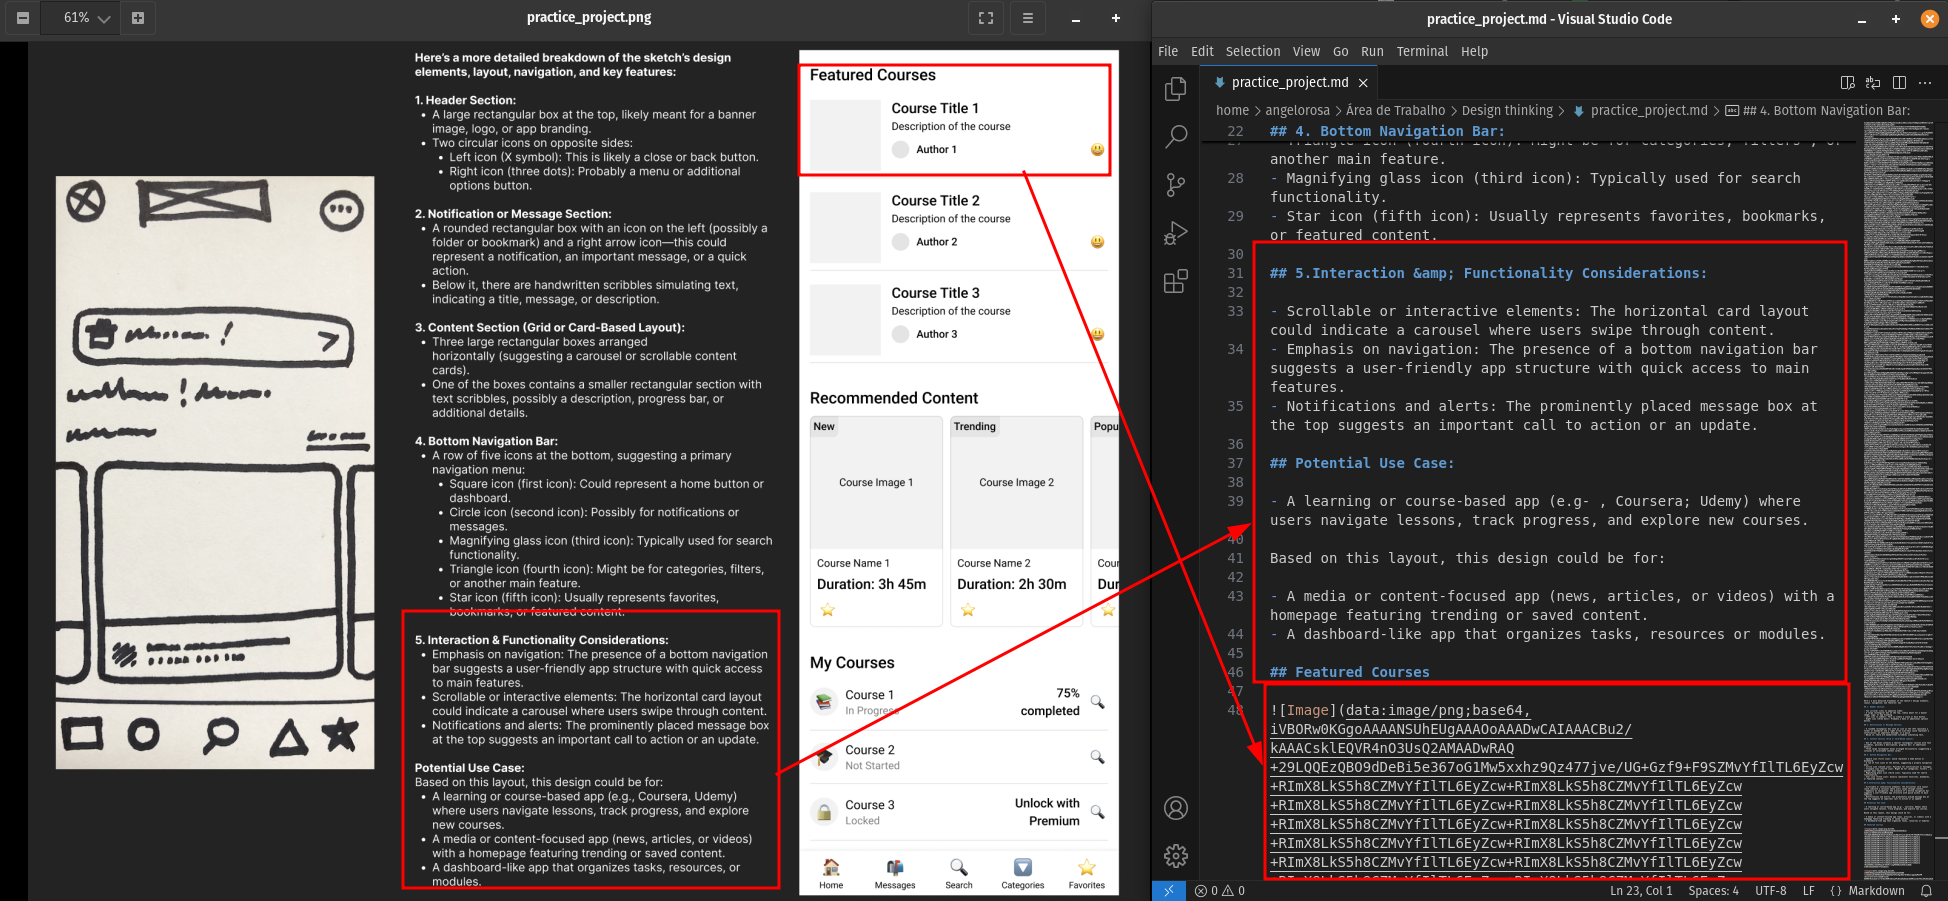
Decidi então elevar o nível do teste e joguei um PNG contendo texto e imagens para conversão. Mais uma vez, a Docling entregou um resultado excelente: extraiu os textos e os converteu para Markdown, mantendo a estrutura organizada, e, ainda melhor, incorporou as imagens ao arquivo usando base64. Isso significa que o arquivo MD gerado ficou completamente portátil, sem depender de links externos ou pastas adicionais para armazenar as imagens.
O impacto disso é gigantesco. Imagine uma ferramenta baseada nessa biblioteca que permita a conversão em lote de todos os documentos de uma empresa. Com isso, seria possível transformar diversos arquivos (PDFs, imagens e outros formatos) em documentos Markdown prontos para serem indexados em um banco vetorial. Isso abriria espaço para implementar sistemas de busca inteligentes baseados em modelos de linguagem (LLM), permitindo que informações antes dispersas sejam recuperadas de forma rápida e eficiente.
Essa experiência me fez enxergar o potencial de automação no processamento de documentos e o quanto tecnologias como essa podem otimizar fluxos de trabalho. Se você também está explorando esse universo, vale muito a pena testar a Docling e pensar nas possibilidades que ela pode abrir!
Link para o repositório, é opensource: https://ds4sd.github.io/docling/